RLM 图解:递归语言模型
让模型学会管理自己的上下文——用 Python REPL + 子 LLM 折叠窗口,对抗 context rot。
一、问题:上下文越长,模型越「腐烂」
agent 能持续干复杂活了,代价是消耗海量 token。而长上下文有两笔硬账:成本随长度线性上涨,能力随长度持续下滑——后者就是著名的 context rot上下文腐烂:模型在上下文变长时能力下降的现象,被称为 context rot。。
二、两条脚手架路线:文件系统 vs 上下文折叠
现有 TUI 系统(Claude Code、Codex)走文件系统路线:用文件 + 定期摘要压缩上下文,形成「一个 agent 接一个 agent」的接力。另一条路是上下文折叠(context folding):不动外部文件,直接在窗口内部管理,让持续增长的 rollout 保持窗口短小。
三、上下文折叠家族:RLM 是「最简单的一种」
| 方法 | 怎么折叠 | 出处 |
|---|---|---|
| Branch & Return | 分支内保留完整上下文,返回后只留自选摘要 | arXiv:2510.11967 |
| AgentFold | 每个动作产出结果 + 推理摘要;摘要可分层合并 | arXiv:2510.24699 |
| Agentic Context Engineering | Generator / Reflector / Curator 三 agent,结构化维护知识库 | arXiv:2510.04618 |
| RLM | Python REPL 检查/变换输入,递归调用子 LLM;从不摘要 | Alex Zhang 2025-10 → arXiv:2512.24601 |
摘要方案天生有损;RLM 把「管理上下文」变成了可学习的行为——模型可以在脚手架内直接训练,越用越会折叠。这更贴近 Bitter Lesson:与其手工设计压缩策略,不如让学习自己发现。
四、RLM 是什么:模型自己管上下文
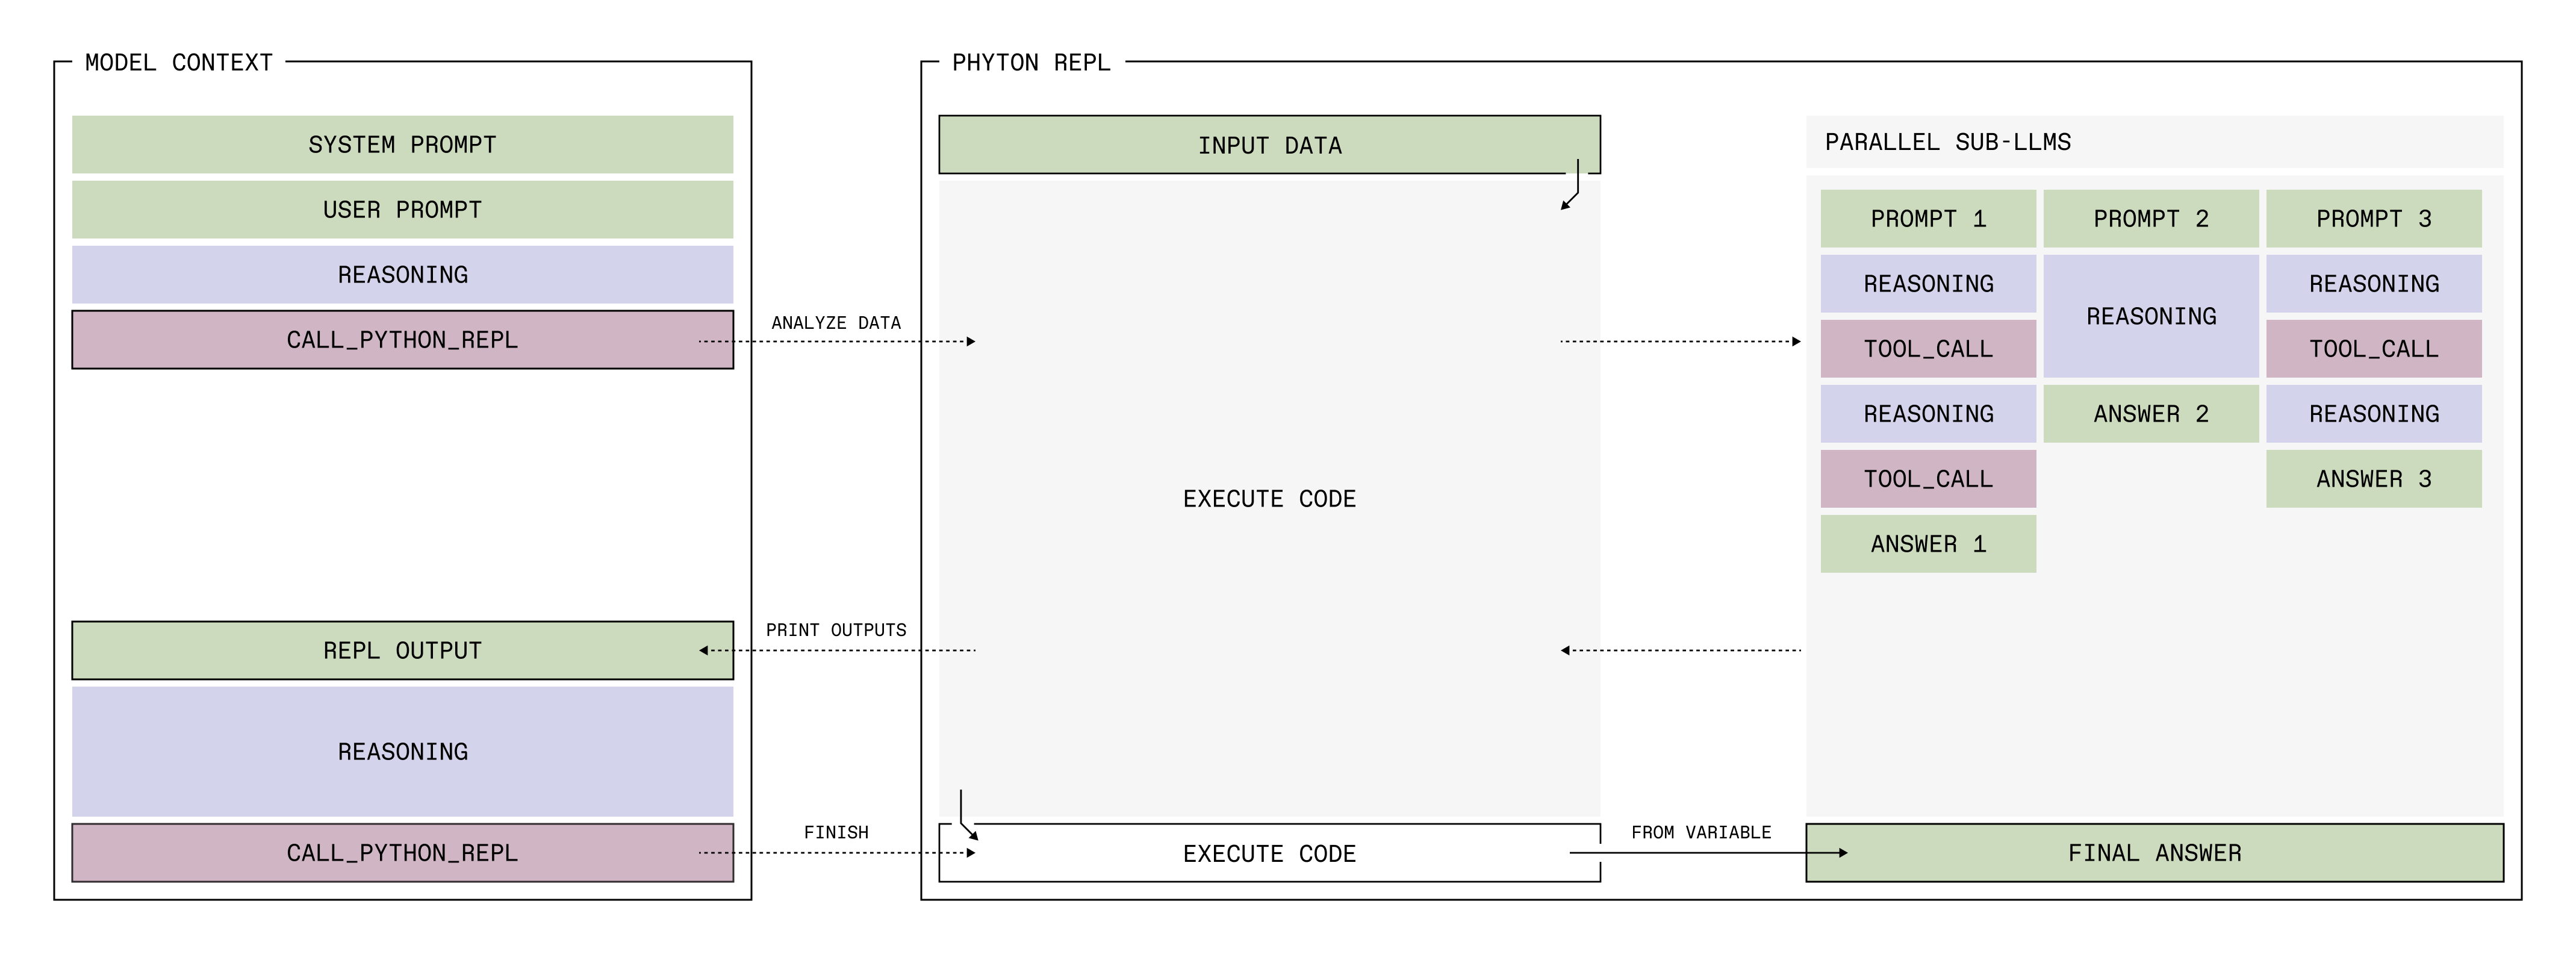
核心机制一句话:输入数据不直接进窗口,只以编程方式暴露给一个持久 Python REPL。模型想看数据就 print,想处理就用 Python,想分担就让子 LLM 上。REPL 每轮回显有 8192 字符上限,逼模型必须学会「用工具而非用眼睛」。
答案用「扩散」生成,不是 one-shot
模型只能通过环境变量交卷:answer = {"content": "", "ready": False}。它可以反复写入、打印、修改 content,直到 ready=True 才结束 rollout——于是「逐字复制」这类任务可以先写一版、再用字符串操作修错,而不是一次赌对。
五、Prime Intellect 的五个实现决策
| 决策 | 内容 | 为什么 |
|---|---|---|
| 子 LLM 可并行 | llm_batch() 批量并行处理 prompt | 把思考 token 规模化,主模型窗口保持短小 |
| 工具只给子 LLM | 环境的搜索/打开网页等工具仅子 LLM 可用 | 工具产生海量 token(单次 open 可上万),主模型不需要看 |
| 任意 pip 包 | numpy / scipy / sympy 等按环境安装,标准库常驻 | 把计算能力交给 Python 生态 |
| 隔离沙箱 | 代码跑在 Prime Intellect Sandboxes | 安全执行任意代码 |
| 递归深度 = 1 | 子 LLM 不能再调子 LLM(未来可变) | 当前阶段先验证单层递归的价值 |
统一哲学:主模型上下文是稀缺资源,一切高 token 的工作都下放——能交给 Python 的交给 Python,能交给子 LLM 的交给子 LLM。
六、实验怎么设计
每个环境比较三种形态:普通 LLM(带默认工具)、RLM、RLM + 环境提示词(教它怎么用脚手架)。主消融用 GPT-5-mini,四个环境各打 50 轮。
| 环境 | 测试什么 | 关键看点 |
|---|---|---|
| DeepDive | 深度研究:search / click / open 工具链 | 工具 token 下放;open 单次可产生上万 token |
| math-python | 难数学题 + Python 工具 | REPL 与普通工具行为几乎相同 → 隔离「脚手架复杂度」成本 |
| Oolong | 长上下文检索聚合(synth / synth+labels / real) | real 数据来自真实 D&D 记录,上下文可达 ~1.5M 字符 |
| verbatim-copy | 逐字复制复杂文本(words/json/csv/codes/mixed) | 考验 answer 变量迭代修改的价值 |
作者明确声明:不为任何模型调参,只看同一环境下 LLM vs RLM 的相对差距。绝对分数不重要。
七、结果:哪些能力被放大,哪些被拖累
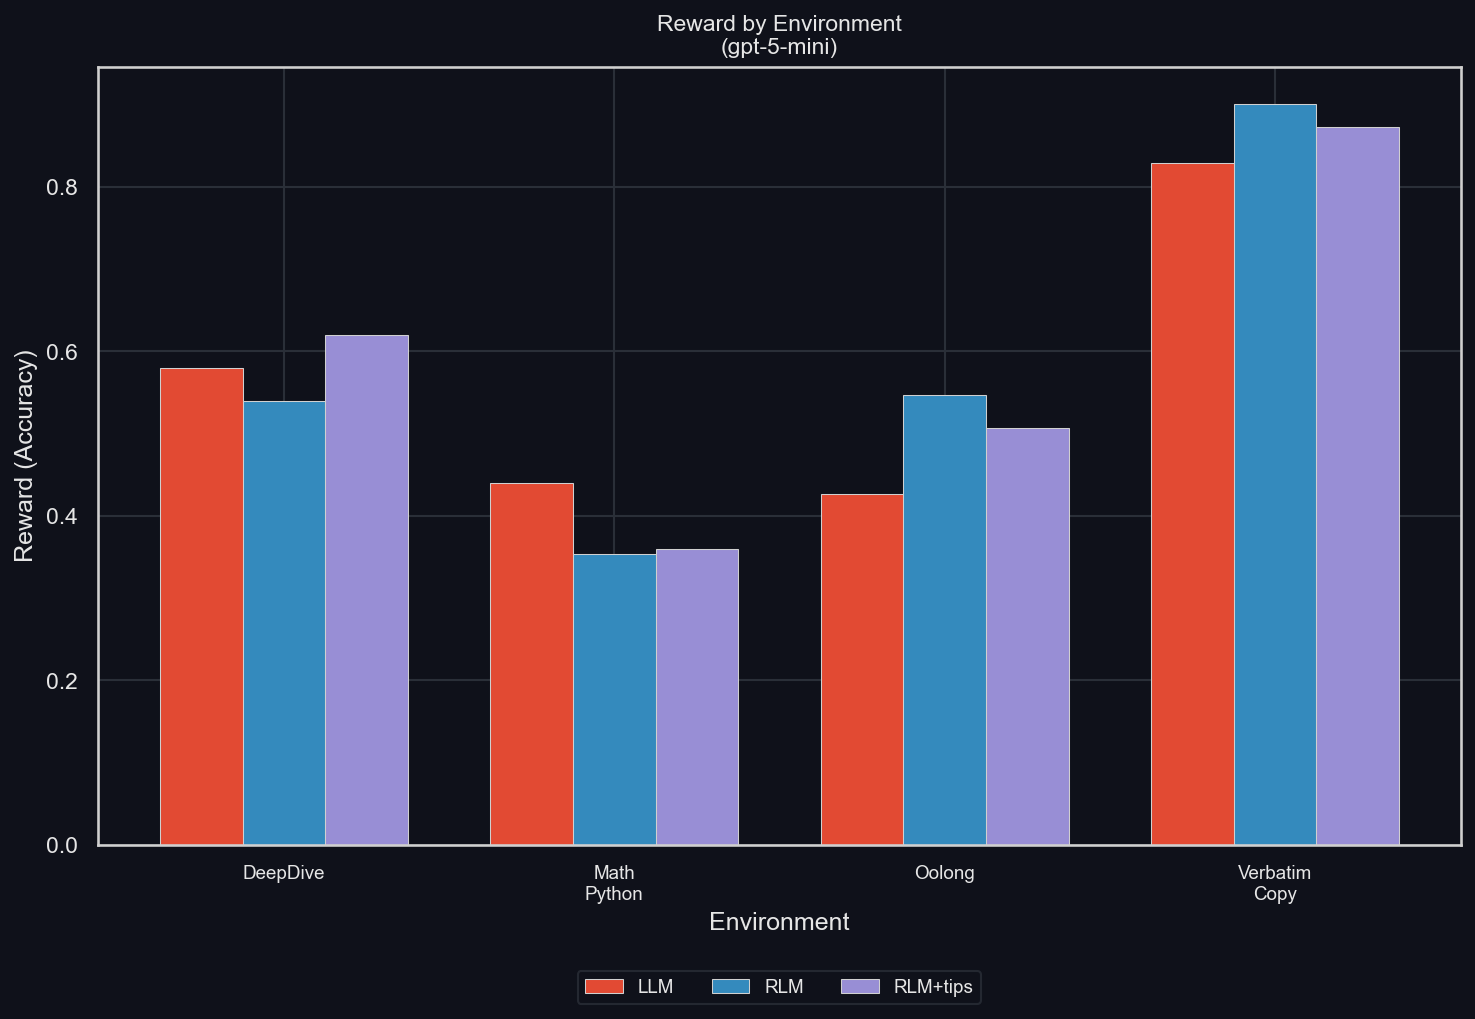
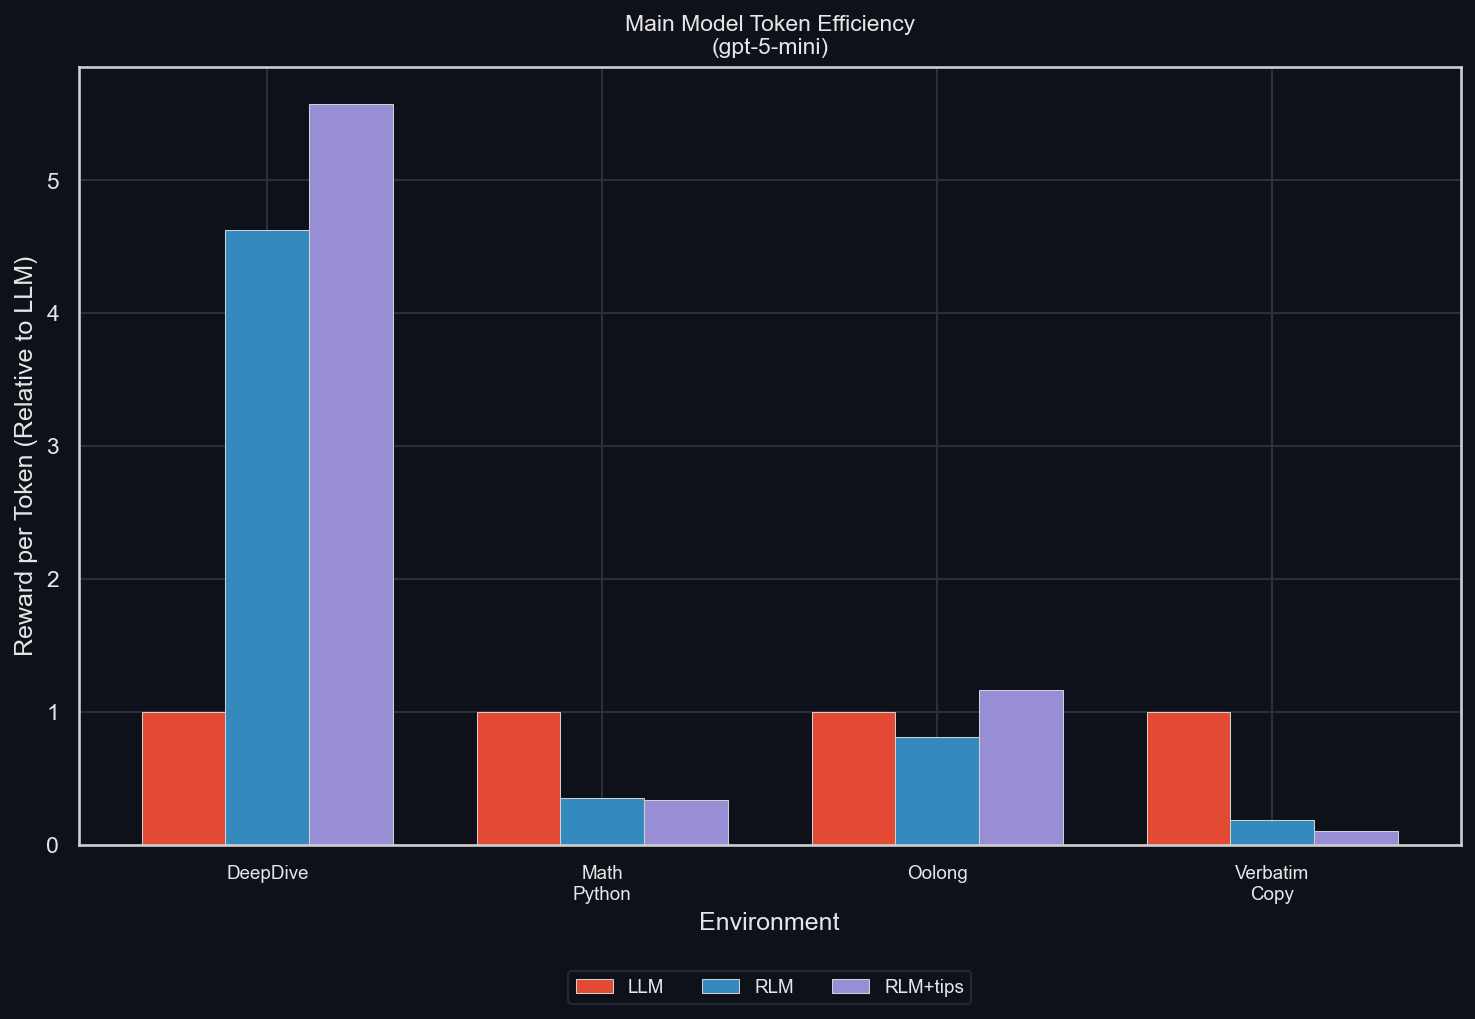
八、模型对照:开源模型的信号
| 模型 | DeepDive | math-python | Oolong | verbatim-copy |
|---|---|---|---|---|
| GLM 4.6 | RLM 近乎翻倍;给 tips 反而崩溃(停止调子 LLM) | 与 GPT-5-mini 一致变差,但只是「想得更少」 | LLM 得 0 分,RLM 非零;最长撑到 ~1.75M 字符 | 无提示词变差,有提示词小幅提升 |
| GLM 4.5 Air | 有 RLM 反而更弱(尽管大量子 LLM 调用) | — | — | — |
| INTELLECT-3 | 重度依赖 tips | 几乎完全不会用 RLM | 趋势同 GPT-5-mini,RLM 胜过 LLM | 无 tips 全类型变差,有 tips 全类型提升 |
开源模型趋势与 GPT-5-mini 一致但不稳定——「会不会用脚手架」对结果的影响远大于模型本身的能力差,这是「需要训练」的最直接证据。
九、折叠 vs 注意力:一个对偶问题
缩放注意力与上下文折叠,其实在回答同一个问题:回看过去时,该忘掉什么?
十、未来:从「外挂脚手架」到「内化能力」
文章反复出现的结论:RLM 的潜力在 RL 训练之后才真正解锁。现在模型是「被塞进脚手架的模型」;未来是「在脚手架里训练出来的模型」——学会主动 branch、并行、下放,而不是等提示词教。
- 递归深度:从 1 变为 0(普通 LLM + REPL)到任意深(子 LLM 再调子 LLM)
- 自定义 REPL 函数与包描述,让模型真正「认识」它的工具
- 多轮之间的上下文压缩成为 RLM 的自然组成部分
- 多模态与自定义数据类型支持(难点在 Sandbox 通信)
- 用 prime-rl 训练模型使用 RLM,从小模型开始
RLM 把「上下文管理」从工程问题变成学习问题:模型用代码和子模型主动折叠自己的窗口,然后通过 RL 越用越会。2026 年的范式之争,可能不是更大的窗口,而是更会管窗口的模型。
来源:Recursive Language Models: the paradigm of 2026 · Sebastian Müller · Prime Intellect Blog · 2026-01-01 · 论文:arXiv:2512.24601